LLM Model Test
🏆 명예의 전당 — 3개 시험 종합
시험마다 v1·v2·v3 점수 평균을 내고, 그 시험별 평균을 다시 1:1:1 로 평균한 점수입니다. 카드의 「최종 작품」은 각 시험의 v3 이고, v3 점수가 600 미만이면 그 시험의 최고점 라운드도 함께 답니다.
ff · Qwen(원본) / ISTA-DASLab(압축)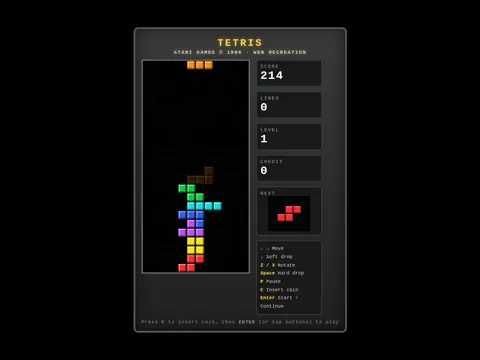
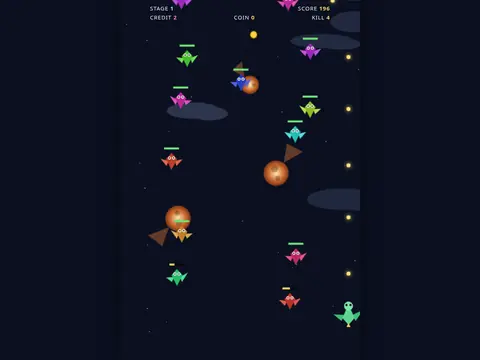
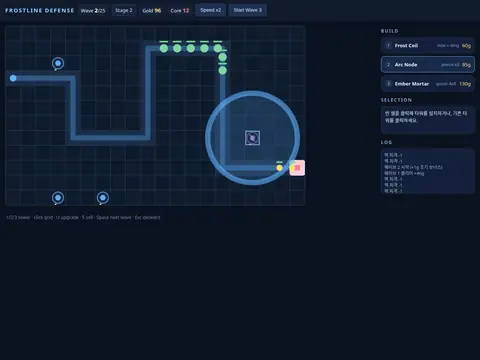
q38 · Alibaba Qwen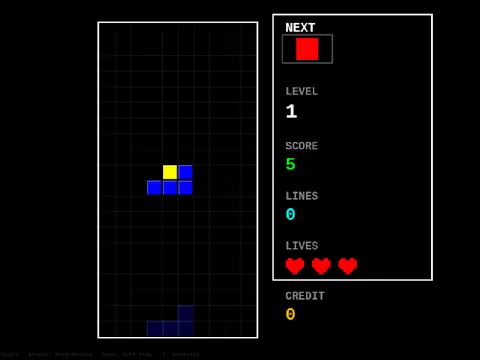
orn · ornith-ai
시험별 종합 순위 TOP 3
테스트마다 v1·v2·v3 점수 평균이 가장 높은 모델입니다. 모든 모델의 게임은 각 테스트 페이지에서 볼 수 있습니다.
llm_model_test — 로컬 LLM 15종 코딩 대회
같은 지시문으로 로컬 LLM 15종에게 브라우저용 게임을 만들게 하고, 실행 시험과 코드 리뷰로 1000점 만점 순위를 매긴다. 시험마다 세 라운드(v1 만들기 → v2 터치 조작 → v3 새 기능)로 이어진다. 시험은 셋(01 테트리스, 02 드래곤플라이트, 03 디펜스)이고 모두 완결됐다.
시험 목록
- 01 테트리스 — v1 만들기, v2 터치 조작, v3 레벨·크레딧·컨티뉴
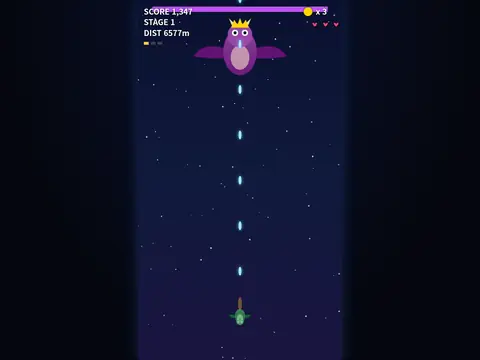
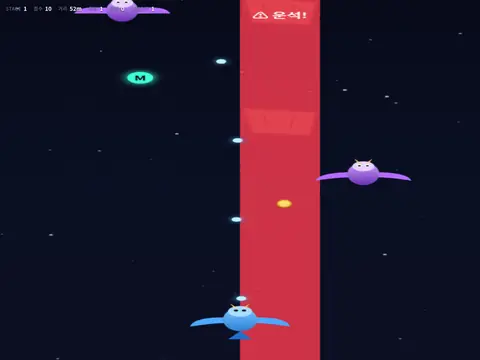
- 02 드래곤플라이트 — v1 만들기, v2 터치 조작, v3 스테이지·크레딧·컨티뉴
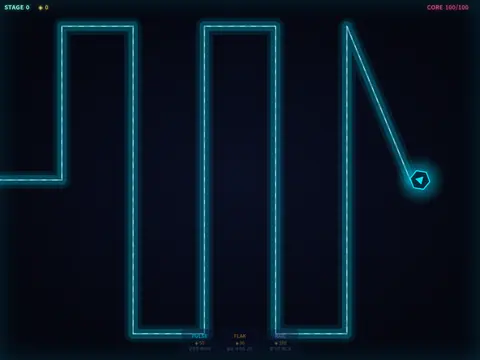
- 03 디펜스(완결) — v1 만들기(장르·기획·디자인은 모델에 맡김), v2 터치 조작, v3 4스테이지마다 보스전
각 테스트 페이지에 라운드별 결과 게임 카드(점수·플레이·코드 링크)와 README(지시문 원문, 채점 방법, 결과 분석)가 있다. 참가 모델 15종의 제원은 모델 정보 에 있다.
규칙
모든 시험 공통
- 서버: AMD Strix Halo(Radeon 8060S, 통합 메모리 64GB) · llama.cpp b11701 router 모드 · 모델은 한 번에 하나.
mel만 b11539 엔진(이유는 01 README 4절).- 에이전트: opencode v1.18.35
opencode run --auto --pure -m halo/<약어>(--pure는 외부 플러그인 없이 실행) — 모델마다 새 세션, 같은 지시문(폴더 이름만 다름). - 샌드박스(bubblewrap): 디스크 전체를 읽기 전용으로 두고, 각 모델은 자기 폴더와 일회용 임시 홈에만 쓸 수 있고 다른 모델의 폴더·서버의 다른 파일은 보이지 않는다.
- 각 모델의 router 기본 설정 그대로(생각 모드·샘플링은 모델별 프리셋).
시험마다 다른 조건
- 만들 게임 — 01·02: 정해 준 게임(01 아타리 1988 테트리스, 02 드래곤플라이트의 게임성) · 03: 장르 해석·기획·디자인까지 모델에 맡김
- 시간 제한 — 01: 모델당 1회 최대 60분 · 02: 모델당 라운드당 최대 60분 · 03: 모델당 라운드당 15분
- 웹 가져오기(webfetch) — 01·02: 거부 · 03: 허용(인터넷 검색, 외부 라이브러리·이미지·소리 사용. 출처·라이선스는 README.md 에 적게 함)
- 서브에이전트·페르소나 — 01: 지시문에 언급 없음 · 02: 서브에이전트 사용 허용 · 03: 페르소나·서브에이전트 사용 허용
- 셸 네트워크 — 01·02: 막지 않음 · 03: 허용
- 01·02 에서는 웹 가져오기 도구만 거부했고 셸 네트워크는 막지 않았다. 그래서 감사했다 — 네트워크 사용 감사(2026-10-17 기준): 실행 기록에서 모델이 셸로 외부에 접속한 흔적 0건 / 결과물 반영 0건. 게임 파일의 외부 URL(CDN·폰트 등)도 0건. 상세는 각 테스트 README 5절.
- 03 은 인터넷을 쓰는 것이 조건의 일부라서, 01·02 의 네트워크 감사와 같은 기준을 적용하지 않는다.
지시문
공통 조건
모든 시험·라운드의 지시문에 들어 있는 조건이다. 지시문은 모델마다 폴더 이름(약어)만 다르고 나머지는 같다.
- 각 모델은 자기 폴더
simple_llm_test_<약어>_<시험>_v<N>안에서 작업한다. - 별도 설치·빌드·서버 없이
index.html을 브라우저로 열면 바로 실행되어야 한다. - 필요한 파일은 모두 그 폴더 안에 둔다.
README.md를 쓴다(게임 소개·실행 방법·조작법·파일 구성, v2 부터는 새 기능 설명을 추가).- v2·v3 는 직전 라운드 결과물의 복사본에서 시작한다(v2 는 자기 v1, v3 는 자기 v2). 기존 기능은 그대로 유지한다.
- 이전 라운드 채점에서 나온 결함·피드백은 모델에게 알려 주지 않는다. 모델마다 매번 새 세션이라 아는 것은 지시문과 폴더 안의 코드뿐이다.
시험별 과제
- 01 테트리스 — v1: 아타리(Atari Games) 1988년 아케이드판 테트리스의 게임성과 그래픽을 최대한 가깝게 재현 → v2: 모바일 터치 조작 추가 → v3: 레벨·크레딧·컨티뉴 도입. 지시문 원문은 01 README 3절.
- 02 드래곤플라이트 — v1: 모바일 게임 「드래곤플라이트」의 게임성을 참고한 세로 스크롤 슈팅(원작의 그림·소리·이름은 복사하지 말고 직접 그리기, 서브에이전트 사용 허용) → v2: 터치 조작 추가(손가락을 끌어 좌우 이동) → v3: 스테이지·크레딧·컨티뉴 도입. 지시문 원문은 02 README 3절.
- 03 디펜스(완결) — v1: 어떤 디펜스 게임으로 만들지(장르 해석·규칙·세계관·화면 구성·조작 방식)와 기획·디자인을 어떻게 진행할지를 모델에 맡김. 인터넷 검색, 외부 라이브러리·이미지·소리(출처·라이선스를 README.md 에 적기), 페르소나·서브에이전트 사용을 허용하고 라운드당 15분 안에 끝낸다. 시작·마감 시각을 알려 주며, 마감이 되면 작업을 강제로 끝내고 그 순간의 결과물로 평가한다 → v2: 모바일 터치 조작 추가 → v3: 스테이지 4개마다 보스전(예: 4·8·12 스테이지). 보스는 일반 적과 다른 체력과 행동 패턴을 갖고, 현재 스테이지와 보스전 여부를 화면에 표시한다. 지시문 원문은 03 README 3절.
평가 (1000점)
라운드마다 채점 기준이 다르다(v1 기본 게임 / v2 터치 조작 / v3 아케이드 기능). 모든 라운드가 1000점 만점이고, 루브릭과 채점 방법은 각 테스트 README 7절에 있다.
종합 순위 = 3라운드 평균(1:1:1).
결과는 각 테스트 페이지에서 본다 — 01 테트리스 · 02 드래곤플라이트 · 03 디펜스. 점수는 결과 게임 카드에, 라운드별 분석은 테스트 README 의 결과 절(9절)에 있다.
대회 종합 — 3개 시험 평균
세 시험(01 테트리스, 02 드래곤플라이트, 03 디펜스)이 모두 완결됐다. 종합 = 세 시험 평균의 평균이고, 각 시험의 평균은 그 시험의 v1~v3 총점 평균(1:1:1)이다. 시험마다 루브릭과 조건이 달라(03 은 15분 제한에 인터넷 허용) 점수 자체보다 순위의 일관성을 보는 표다. 괄호는 그 시험의 종합 순위다.
| 순위 | 모델 | 종합(3시험 평균) | 테트리스 | 드래곤플라이트 | 디펜스 |
|---|---|---|---|---|---|
| 1 | ff | 876.7 | 886.5 (1위) | 850.7 (2위) | 893 (1위) |
| 2 | q38 | 753.2 | 745.2 (2위) | 894.7 (1위) | 619.7 (6위) |
| 3 | orn | 732.9 | 539.8 (8위) | 826.7 (4위) | 832.3 (2위) |
| 4 | mcv | 682.7 | 648.8 (5위) | 695 (6위) | 704.3 (5위) |
| 5 | aw | 681.7 | 737.5 (3위) | 504 (8위) | 803.7 (3위) |
| 6 | mg | 635.1 | 645.8 (6위) | 496 (9위) | 763.3 (4위) |
| 7 | cn | 573 | 674.5 (4위) | 676.2 (7위) | 368.3 (10위) |
| 8 | q36 | 550.6 | 637.3 (7위) | 734.3 (5위) | 280 (11위) |
| 9 | fn | 545.3 | 358.7 (9위) | 836.7 (3위) | 440.7 (7위) |
| 10 | bolt | 386.7 | 307 (10위) | 469.3 (10위) | 383.7 (9위) |
| 11 | mel | 346.7 | 237.7 (12위) | 385 (12위) | 417.3 (8위) |
| 12 | lfm | 294.2 | 282.7 (11위) | 398.7 (11위) | 201.3 (12위) |
| 13 (공동) | c7r | 0 | 0 (공동 13위) | 0 (공동 13위) | 0 (공동 13위) |
| 13 (공동) | c7 | 0 | 0 (공동 13위) | 0 (공동 13위) | 0 (공동 13위) |
| 13 (공동) | c1 | 0 | 0 (공동 13위) | 0 (공동 13위) | 0 (공동 13위) |
해설
ff가 세 시험 모두 최상위권이고 종합 우승(876.7)이다. 테트리스 1위(886.5), 드래곤플라이트 2위(850.7), 디펜스 1위(893.0). 시험마다 우승은 테트리스ff, 드래곤플라이트q38(894.7), 디펜스ff였다.q38은 드래곤플라이트 1위인데 디펜스 v3 에서 무너졌다. 드래곤플라이트 세 라운드가 903 → 881 → 900 이고 테트리스 종합도 2위(745.2)지만, 디펜스 v3 에서 새 기능을 얹다가 적 이동 줄을 지워 v2 의 864점이 306점이 됐다. 디펜스 평균은 619.7(6위)로 내려갔고 종합은 2위(753.2)다.orn은 빠른 생성과 안정적인 코드 품질을 보였다. 순위가 테트리스 8위, 드래곤플라이트 4위, 디펜스 2위로 시험을 거듭할수록 올랐고, 아홉 라운드 생성 시간의 합이 약 30분으로 상위 3종(ff약 92분,q38약 122분) 가운데 가장 짧다. 디펜스에서는 코드 품질(5절) 점수가 세 라운드 모두 가장 높았다.aw는 월드 모델(코딩 에이전트용이 아닌 환경 시뮬레이터)인데도 디펜스 3위(803.7)다. 테트리스 3위, 드래곤플라이트 8위(v1 에서는 파일을 하나도 만들지 못했다)로 시험에 따라 편차가 크고 종합은 5위(681.7)다.- 소형 모델
c1·c7·c7r은 세 시험 아홉 라운드 모두 0점이다. 매번 몇 초에서 1~2분 안에 끝났고 파일을 하나도 만들지 못했다. - 피드백이 없으면 이전 라운드의 결함은 거의 고쳐지지 않았다. 테트리스의
aw(중력 없음)와q38(충돌 결함), 드래곤플라이트의mcv(탄 판정 NaN)와cn(적 미출현), 디펜스의q36(입력을 막는 덮개)은 모두 세 라운드 내내 그대로였다. 확인된 예외는 디펜스 v3 의cn하나로, v2 의 문법 오류를 스스로 고쳐 182 → 217 → 706 으로 올랐다. - 생성 시간과 품질은 약하게만 이어진다. 아홉 라운드 생성 시간의 합이 가장 긴 모델은
q38(약 2시간 2분),fn(약 1시간 39분),ff(약 1시간 32분)인데 종합 순위는 2위, 9위, 1위다. 시간 순위와 종합 순위의 상관은 약한 양(스피어만 약 0.45, 파일을 만든 12종)이고,mcv(약 22분에 4위)와orn(약 30분에 3위)처럼 짧게 쓰고 높은 순위를 낸 모델도 있다.
각 시험의 결과 분석은 01 테트리스 · 02 드래곤플라이트 · 03 디펜스 의 결과 절에, 모델별 제원과 참가 기록은 모델 정보 에 있다.